
ভিশন ল্যাঙ্গুয়েজ মডেলের মাধ্যমে দক্ষ পিডিএফ টেক্সট নিষ্কাশন —— কেন olmOCR গেম পরিবর্তন করে
olmOCR কীভাবে এআই-চালিত টেক্সট নিষ্কাশন, খরচ-কার্যকারিতা এবং ওপেন-সোর্স উদ্ভাবনের মাধ্যমে পিডিএফ প্রক্রিয়াকরণকে রূপান্তরিত করে তা আবিষ্কার করুন।
 Free OLM OCR Team
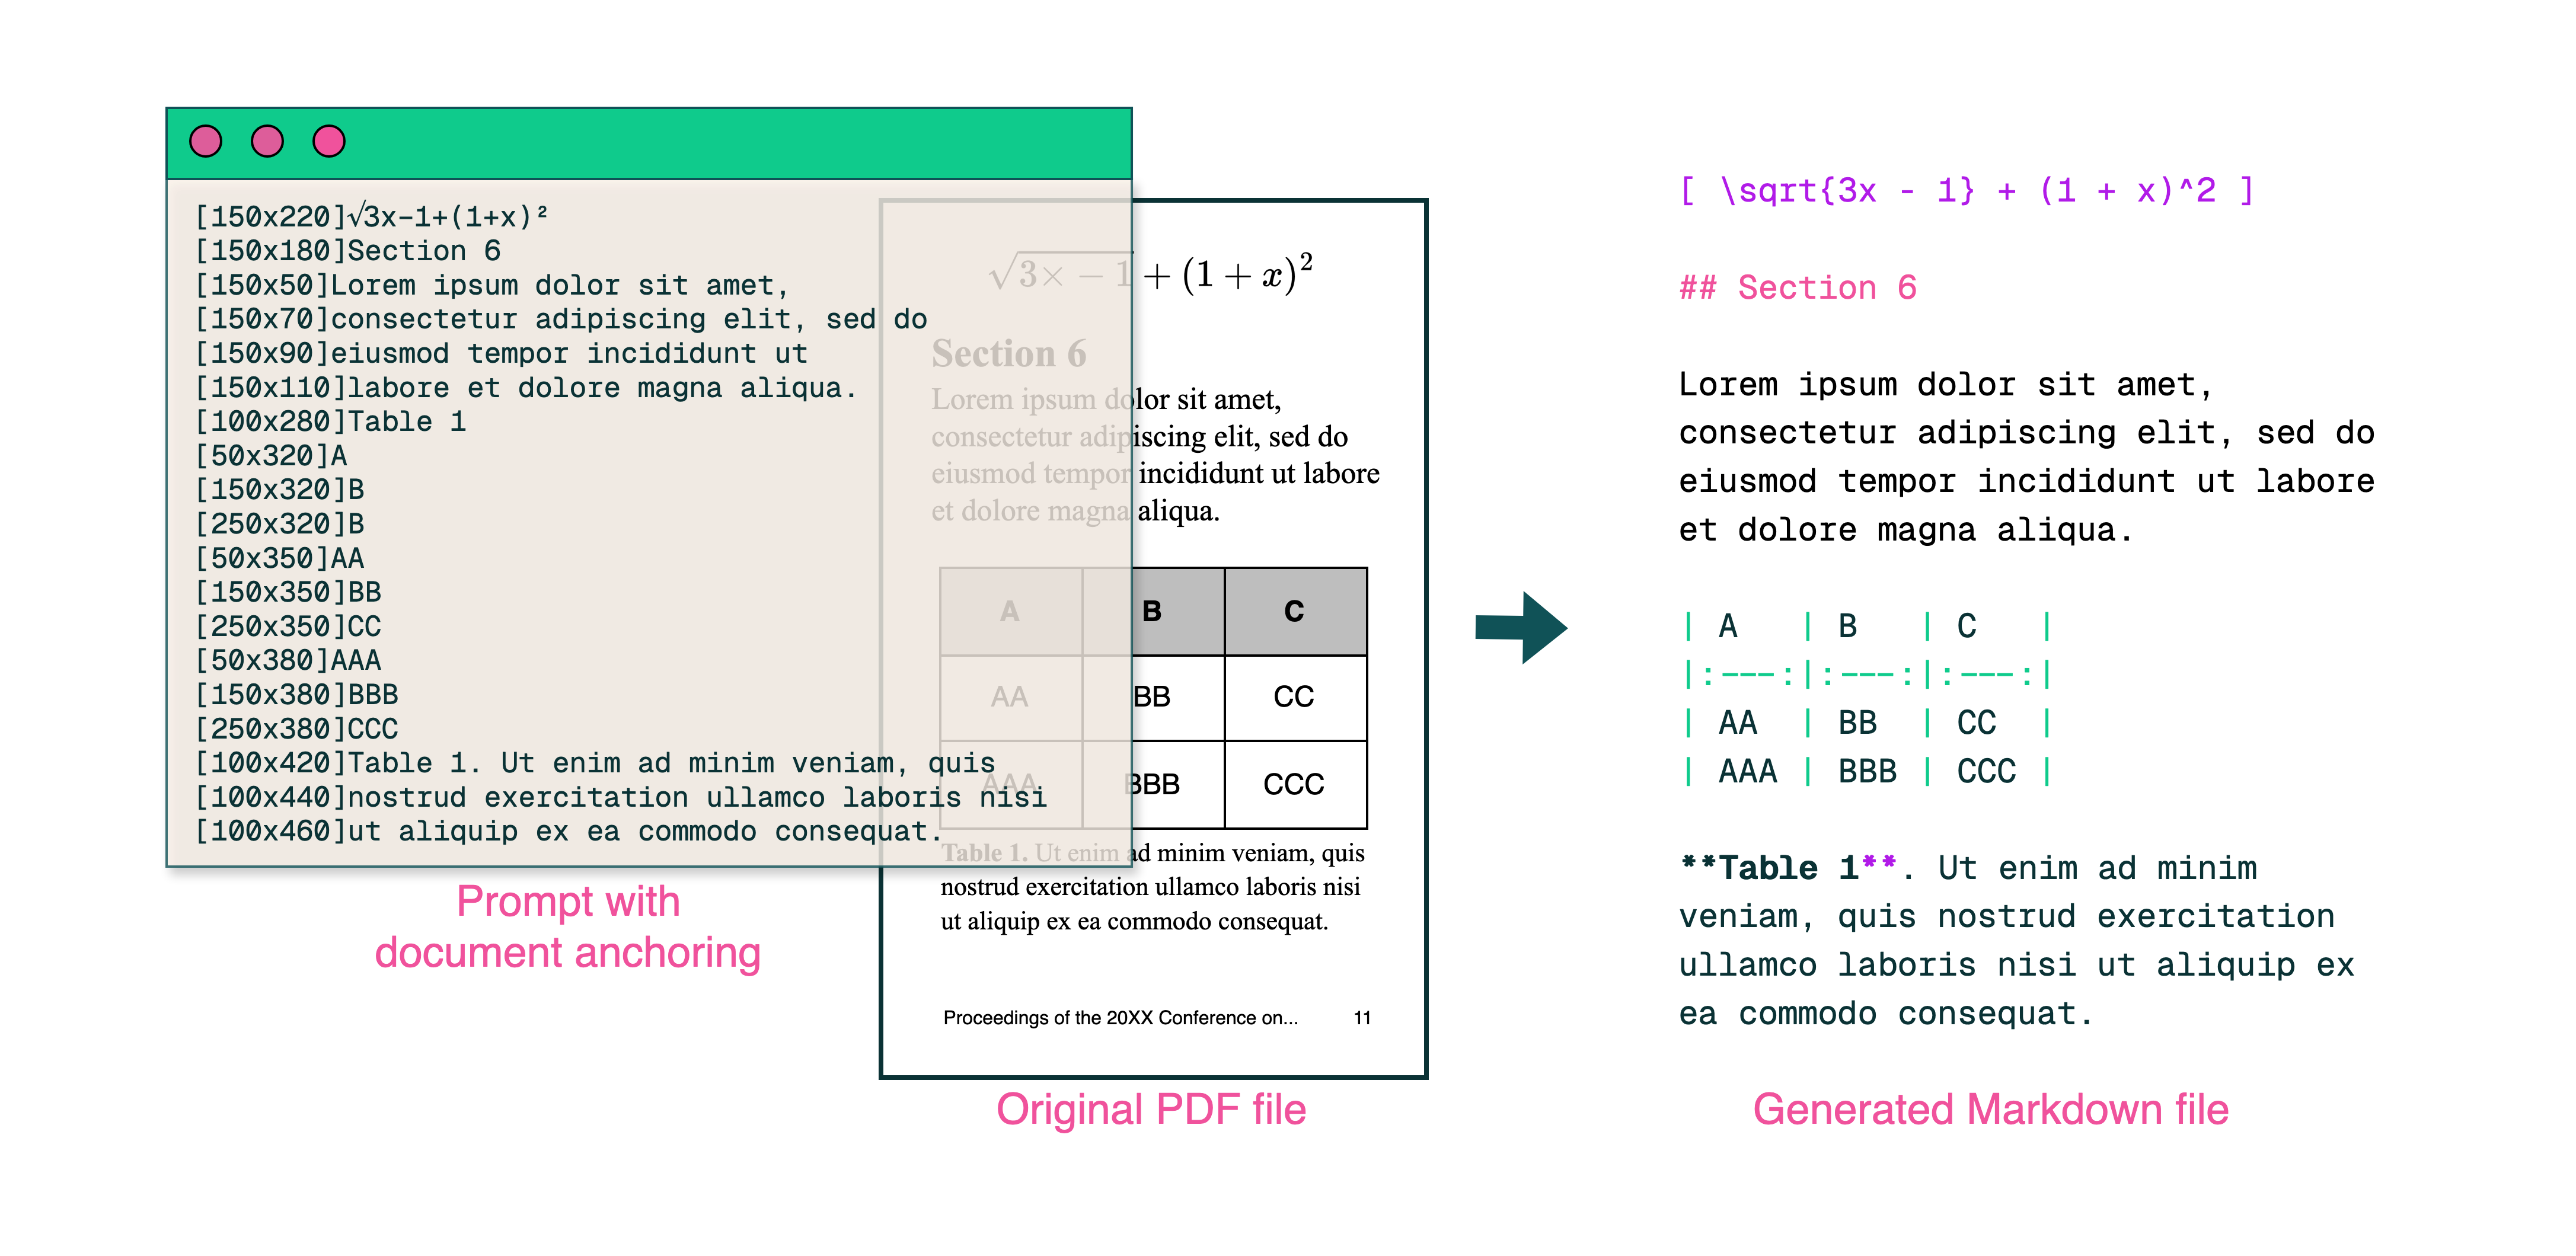
ক্যাপশন: olmOCR-এর এন্ড-টু-এন্ড পাইপলাইন এলোমেলো পিডিএফ-কে GPT-4o-এর খরচের ১/৩২ অংশে কাঠামোগত মার্কডাউন টেক্সটে রূপান্তর করে।
পিডিএফ-এর লুকানো চ্যালেঞ্জ: কেন সাধারণ টেক্সট গুরুত্বপূর্ণ
ভাষা মডেলগুলি পরিষ্কার টেক্সটের উপর ভালো কাজ করে—কিন্তু পিডিএফ হল চূড়ান্ত শত্রু। প্রিন্টিংয়ের জন্য ডিজাইন করা হয়েছে, পার্সিংয়ের জন্য নয়, এগুলি টেক্সটের অবস্থান এলোমেলো করে, বাইনারি কোডে টেবিলগুলিকে লুকিয়ে রাখে এবং সমীকরণগুলিকে ভিজ্যুয়াল ধাঁধায় পরিণত করে। ঐতিহ্যবাহী OCR সরঞ্জাম? এগুলি প্রায়শই ফর্ম্যাটিং মিস করে, মাল্টি-কলাম লেআউটের সাথে লড়াই করে বা প্রচুর চার্জ করে।
আসুন olmOCR-এর সাথে পরিচিত হই: একটি ওপেন-সোর্স টুলকিট যা পিডিএফ কোড ক্র্যাক করার জন্য ভিশন-ল্যাঙ্গুয়েজ মডেল (VLMs) এবং স্মার্ট ইঞ্জিনিয়ারিং একত্রিত করে। আসুন জেনে নেওয়া যাক কেন ডেভেলপার এবং গবেষকরা এটি নিয়ে আলোচনা করছেন।
৫টি কারণ olmOCR অন্যান্য সরঞ্জামকে ছাড়িয়ে যায়
১. খরচ-কার্যকারিতা যা উপেক্ষা করা কঠিন
 ১ মিলিয়ন পৃষ্ঠা প্রক্রিয়া করুন $190-এ—যা GPT-4o ব্যাচ API-এর চেয়ে ৩২ গুণ সস্তা। কিভাবে? ২৫০K বিভিন্ন পৃষ্ঠা (একাডেমিক পেপার, আইনি নথি, এমনকি হাতে লেখা চিঠি) এর উপর ফাইন-টিউন করে এবং SGLang/vLLM-এর সাথে ইনফারেন্স অপটিমাইজ করে।
২. মার্কডাউন জাদু আর কোনো রেজেক্স দুঃস্বপ্ন নয়। olmOCR পরিষ্কার মার্কডাউন আউটপুট করে যার মধ্যে রয়েছে:
- সংরক্ষিত সমীকরণ (
E=mc²) - টেবিল যা টেবিল হিসাবে থাকে
- জটিল লেআউটের জন্য সঠিক পাঠের ক্রম
৩. ব্যাটারি-অন্তর্ভুক্ত পাইপলাইন
python -m olmocr.pipeline ./workspace --pdfs your_file.pdf
১ থেকে ১০০+ GPU পর্যন্ত নির্বিঘ্নে স্কেল করুন। বিল্ট-ইন ত্রুটি হ্যান্ডলিং মেটাডেটা দুর্নীতি-এর মতো সাধারণ পিডিএফ সমস্যাগুলি সমাধান করে।
৪. ওপেন সোর্স, শূন্য ব্ল্যাক বক্স ওয়েটস, প্রশিক্ষণ ডেটা (হ্যাঁ, সমস্ত ২৫০K পৃষ্ঠা!), এবং কোড সর্বজনীন। Qwen2-VL-7B-Instruct এর উপর নির্মিত—কোনো মালিকানা নির্ভরতা নেই।
৫. মানব-প্রমাণিত শ্রেষ্ঠত্ব
Marker, GOT-OCR 2.0, এবং MinerU-এর বিরুদ্ধে অন্ধ পরীক্ষায়:
- তুলনাগুলির ৬১% জিতেছে
- ELO >1800 (গোল্ড স্ট্যান্ডার্ড) অর্জন করে
হুডের নিচে: আমরা কীভাবে olmOCR তৈরি করেছি
ডকুমেন্ট অ্যাঙ্করিং: গোপন সস
 ক্যাপশন: টেক্সট + ইমেজ প্রসঙ্গ = সঠিক নিষ্কাশন।
আমরা প্রশিক্ষণের সময় VLMs "অ্যাঙ্কর" করতে পিডিএফ-এর নিজস্ব টেক্সট/মেটাডেটা ব্যবহার করি: ১. টেক্সট ব্লক এবং ইমেজ অঞ্চলগুলি বের করুন ২. মডেল প্রম্পটগুলিতে সেগুলিকে একত্রিত করুন ৩. GPT-4o কে "গোল্ড স্ট্যান্ডার্ড" লেবেল তৈরি করতে দিন
ফলাফল? এমন একটি মডেল যা টেক্সট কী বলে এবং এটি কোথায় আছে তা উভয়ই বোঝে।
বাস্তব বিশ্বের জন্য প্রশিক্ষণ
- ডেটাসেট: ৬০% একাডেমিক পেপার, ১২% ব্রোশার, ১১% আইনি নথি
- হার্ডওয়্যার: NVIDIA GPU-এর জন্য অপটিমাইজ করা হয়েছে, তুলনামূলক সেটআপের চেয়ে ৯০% কম শক্তি ব্যবহার করে
- ফাইন-টিউনিং: ডকুমেন্ট "কথোপকথন"-এর জন্য Qwen2-VL-7B-Instruct মানিয়ে নেওয়া হয়েছে
৩ মিনিটের মধ্যে olmOCR ব্যবহার করে দেখুন
১. ইনস্টল করুন
git clone https://github.com/allenai/olmocr && cd olmocr
pip install -e .
২. নমুনা পিডিএফ-এ চালান
python -m olmocr.pipeline ./demo_output --pdfs tests/gnarly_pdfs/horribleocr.pdf
৩. মার্কডাউন পরীক্ষা করুন
./demo_output/horribleocr.md খুলুন—টেবিল, সমীকরণ এবং টেক্সট প্রবাহ অক্ষত দেখুন!
চূড়ান্ত মন্তব্য
olmOCR শুধু আরেকটি সরঞ্জাম নয়—এটি একটি দৃষ্টান্ত পরিবর্তন। স্বচ্ছ প্রকৌশলের সাথে VLMs-এর সংমিশ্রণ করে, এটি সবার জন্য উচ্চ-মানের টেক্সট নিষ্কাশনযোগ্য করে তোলে। আপনি একটি গবেষণা কর্পাস তৈরি করছেন বা চালান প্রক্রিয়াকরণ স্বয়ংক্রিয় করছেন না কেন, এই টুলকিটটি আপনার স্ট্যাকে থাকা উচিত।
পরবর্তী পদক্ষেপ
- ⭐ GitHub রিপো -এ স্টার দিন
- 📊 ইন্টারেক্টিভ টুল ব্যবহার করে আউটপুট তুলনা করুন
- 💬 Hugging Face-এ আলোচনায় যোগ দিন
আসুন পিডিএফ যন্ত্রণা-কে সাধারণ টেক্সট লাভে পরিণত করি! 🚀