
Efektivní extrakce textu z PDF pomocí modelů Vision Language
Objevte, jak olmOCR transformuje zpracování PDF s extrakcí textu řízenou umělou inteligencí, nákladovou efektivitou a open-source inovacemi.
 Free OLM OCR Team
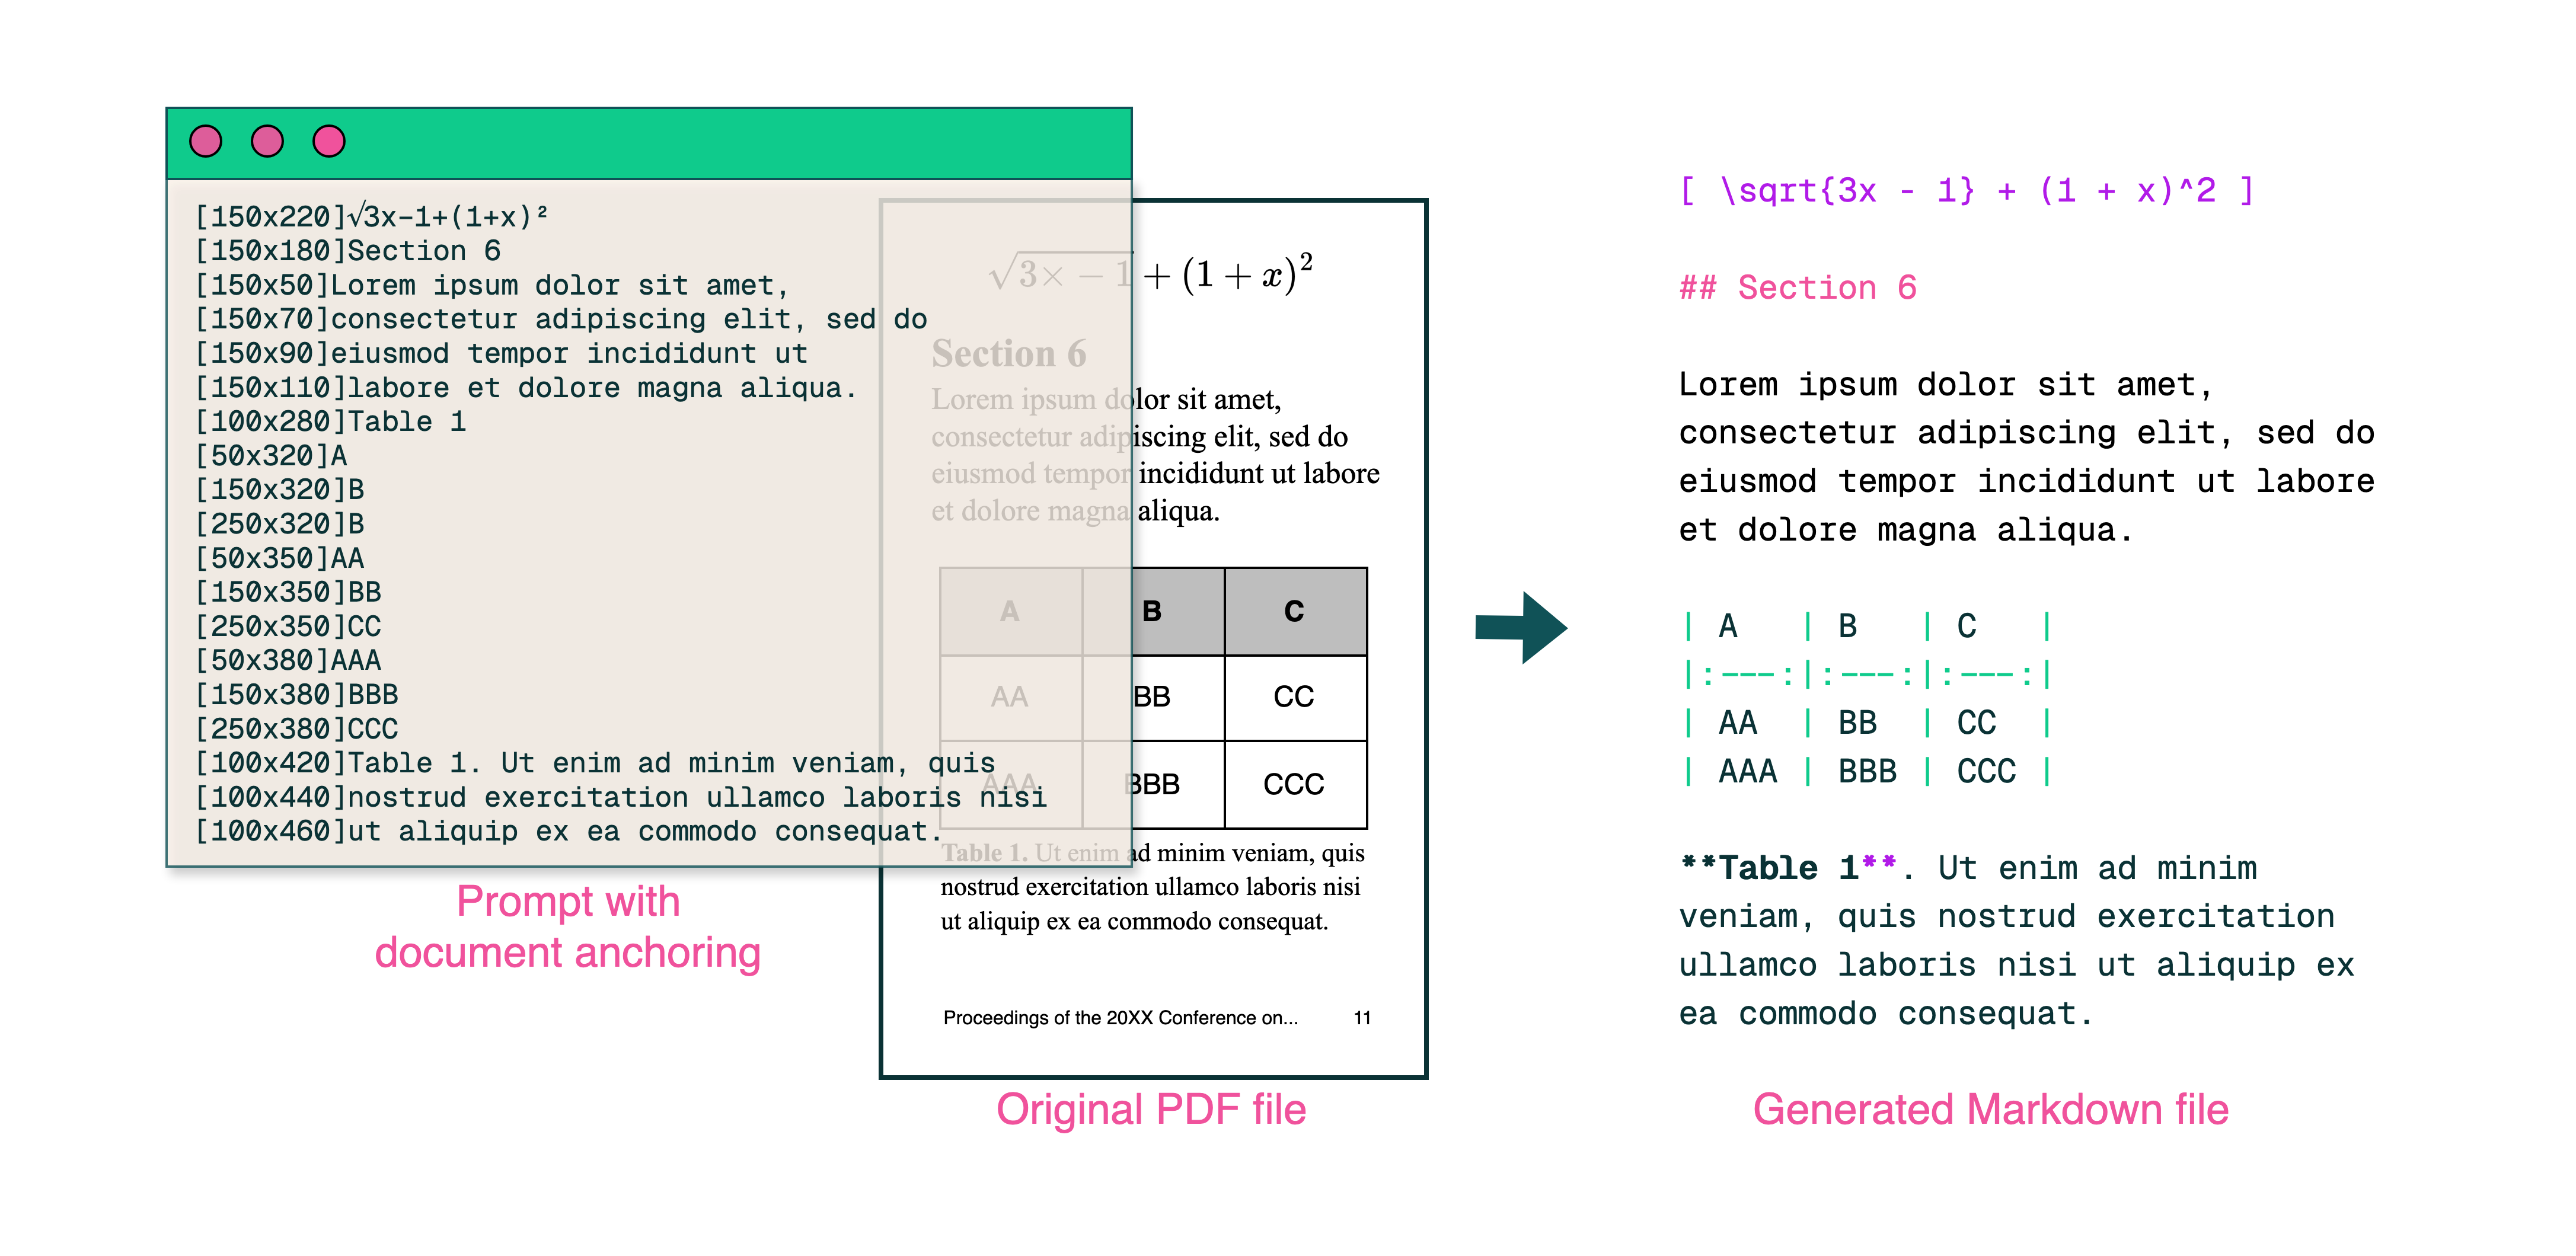
Popisek: Komplexní pipeline olmOCR převádí chaotické PDF do strukturovaného textu ve formátu Markdown za 1/32 nákladů GPT-4o.
Skrytá výzva PDF: Proč na prostém textu záleží
Jazykové modely prosperují na čistém textu – ale PDF jsou ultimátní nepřítel s výhodami. Jsou navrženy pro tisk, nikoli pro parsování, zamotávají pozice textu, pohřbívají tabulky v binárním kódu a proměňují rovnice ve vizuální hádanky. Tradiční OCR nástroje? Často jim uniká formátování, potýkají se s vícesloupcovými rozvrženími nebo si účtují jmění.
Vstupte do olmOCR: open-source toolkit, který kombinuje modely vision-language (VLM) s chytrým inženýrstvím, aby prolomil kód PDF. Rozeberme si, proč o něm vývojáři a výzkumníci tolik mluví.
5 důvodů, proč olmOCR překonává ostatní nástroje
-
Nákladová efektivita, kterou je těžké ignorovat
 Zpracujte 1 milion stran za 190 $ – to je 32x levnější než dávkové API GPT-4o. Jak? Díky doladění na 250 tisících různých stranách (akademické práce, právní dokumenty, dokonce i ručně psané dopisy) a optimalizaci inference s SGLang/vLLM.
-
Markdown magie Už žádné regex noční můry. olmOCR generuje čistý Markdown s:
- Zachovanými rovnicemi (
E=mc²) - Tabulkami, které zůstávají tabulkami
- Správným pořadím čtení pro složitá rozvržení
- Zachovanými rovnicemi (
-
Pipeline s veškerým vybavením
python -m olmocr.pipeline ./workspace --pdfs your_file.pdfBezproblémové škálování od 1 do 100+ GPU. Vestavěná správa chyb řeší běžné PDF gremliny, jako je poškození metadat.
-
Open Source, žádné černé skříňky Váhy, tréninková data (ano, všech 250 tisíc stran!) a kód jsou veřejné. Postaveno na Qwen2-VL-7B-Instruct – žádné proprietární závislosti.
-
Lidmi ověřená nadřazenost
V slepých testech proti Marker, GOT-OCR 2.0 a MinerU:- Vyhrává 61 % srovnání
- Dosahuje ELO >1800 (zlatý standard)
Pod pokličkou: Jak jsme postavili olmOCR
Ukazování dokumentů: Tajná omáčka
 Popisek: Kontext textu + obrázku = přesná extrakce.
Používáme vlastní text/metadata PDF k "ukotvení" VLM během tréninku:
- Extrahujte textové bloky a oblasti obrázků
- Zkombinujte je v modelech výzev
- Nechte GPT-4o generovat "zlatý standard" štítky
Výsledek? Model, který chápe co text říká a kam patří.
Trénink pro reálný svět
- Datová sada: 60 % akademické práce, 12 % brožury, 11 % právní dokumenty
- Hardware: Optimalizováno pro NVIDIA GPU, 90 % nižší spotřeba energie než srovnatelné sestavy
- Doladění: Qwen2-VL-7B-Instruct adaptováno pro dokumentové "konverzace"
Vyzkoušejte olmOCR za 3 minuty
- Instalace
git clone https://github.com/allenai/olmocr && cd olmocr pip install -e . - Spuštění na ukázkovém PDF
python -m olmocr.pipeline ./demo_output --pdfs tests/gnarly_pdfs/horribleocr.pdf - Zkontrolujte Markdown
Otevřete
./demo_output/horribleocr.md– uvidíte tabulky, rovnice a tok textu neporušený!
Závěrečné shrnutí
olmOCR není jen další nástroj – je to posun paradigmatu. Spojením VLM s transparentním inženýrstvím zpřístupňuje vysoce kvalitní extrakci textu všem. Ať už budujete výzkumný korpus nebo automatizujete zpracování faktur, tento toolkit patří do vašeho zásobníku.
Další kroky
- ⭐ Ohvězdičkujte GitHub repo
- 📊 Porovnejte výstupy pomocí Interaktivního nástroje
- 💬 Připojte se k diskuzi na Hugging Face
Proměňme bolest PDF na zisk z prostého textu! 🚀