
Vision Language Modelsによる効率的なPDFテキスト抽出 —— olmOCRがゲームを変える理由
olmOCRがAI駆動のテキスト抽出、コスト効率、オープンソースの革新でPDF処理をどのように変革するかをご覧ください。
 Free OLM OCR Team
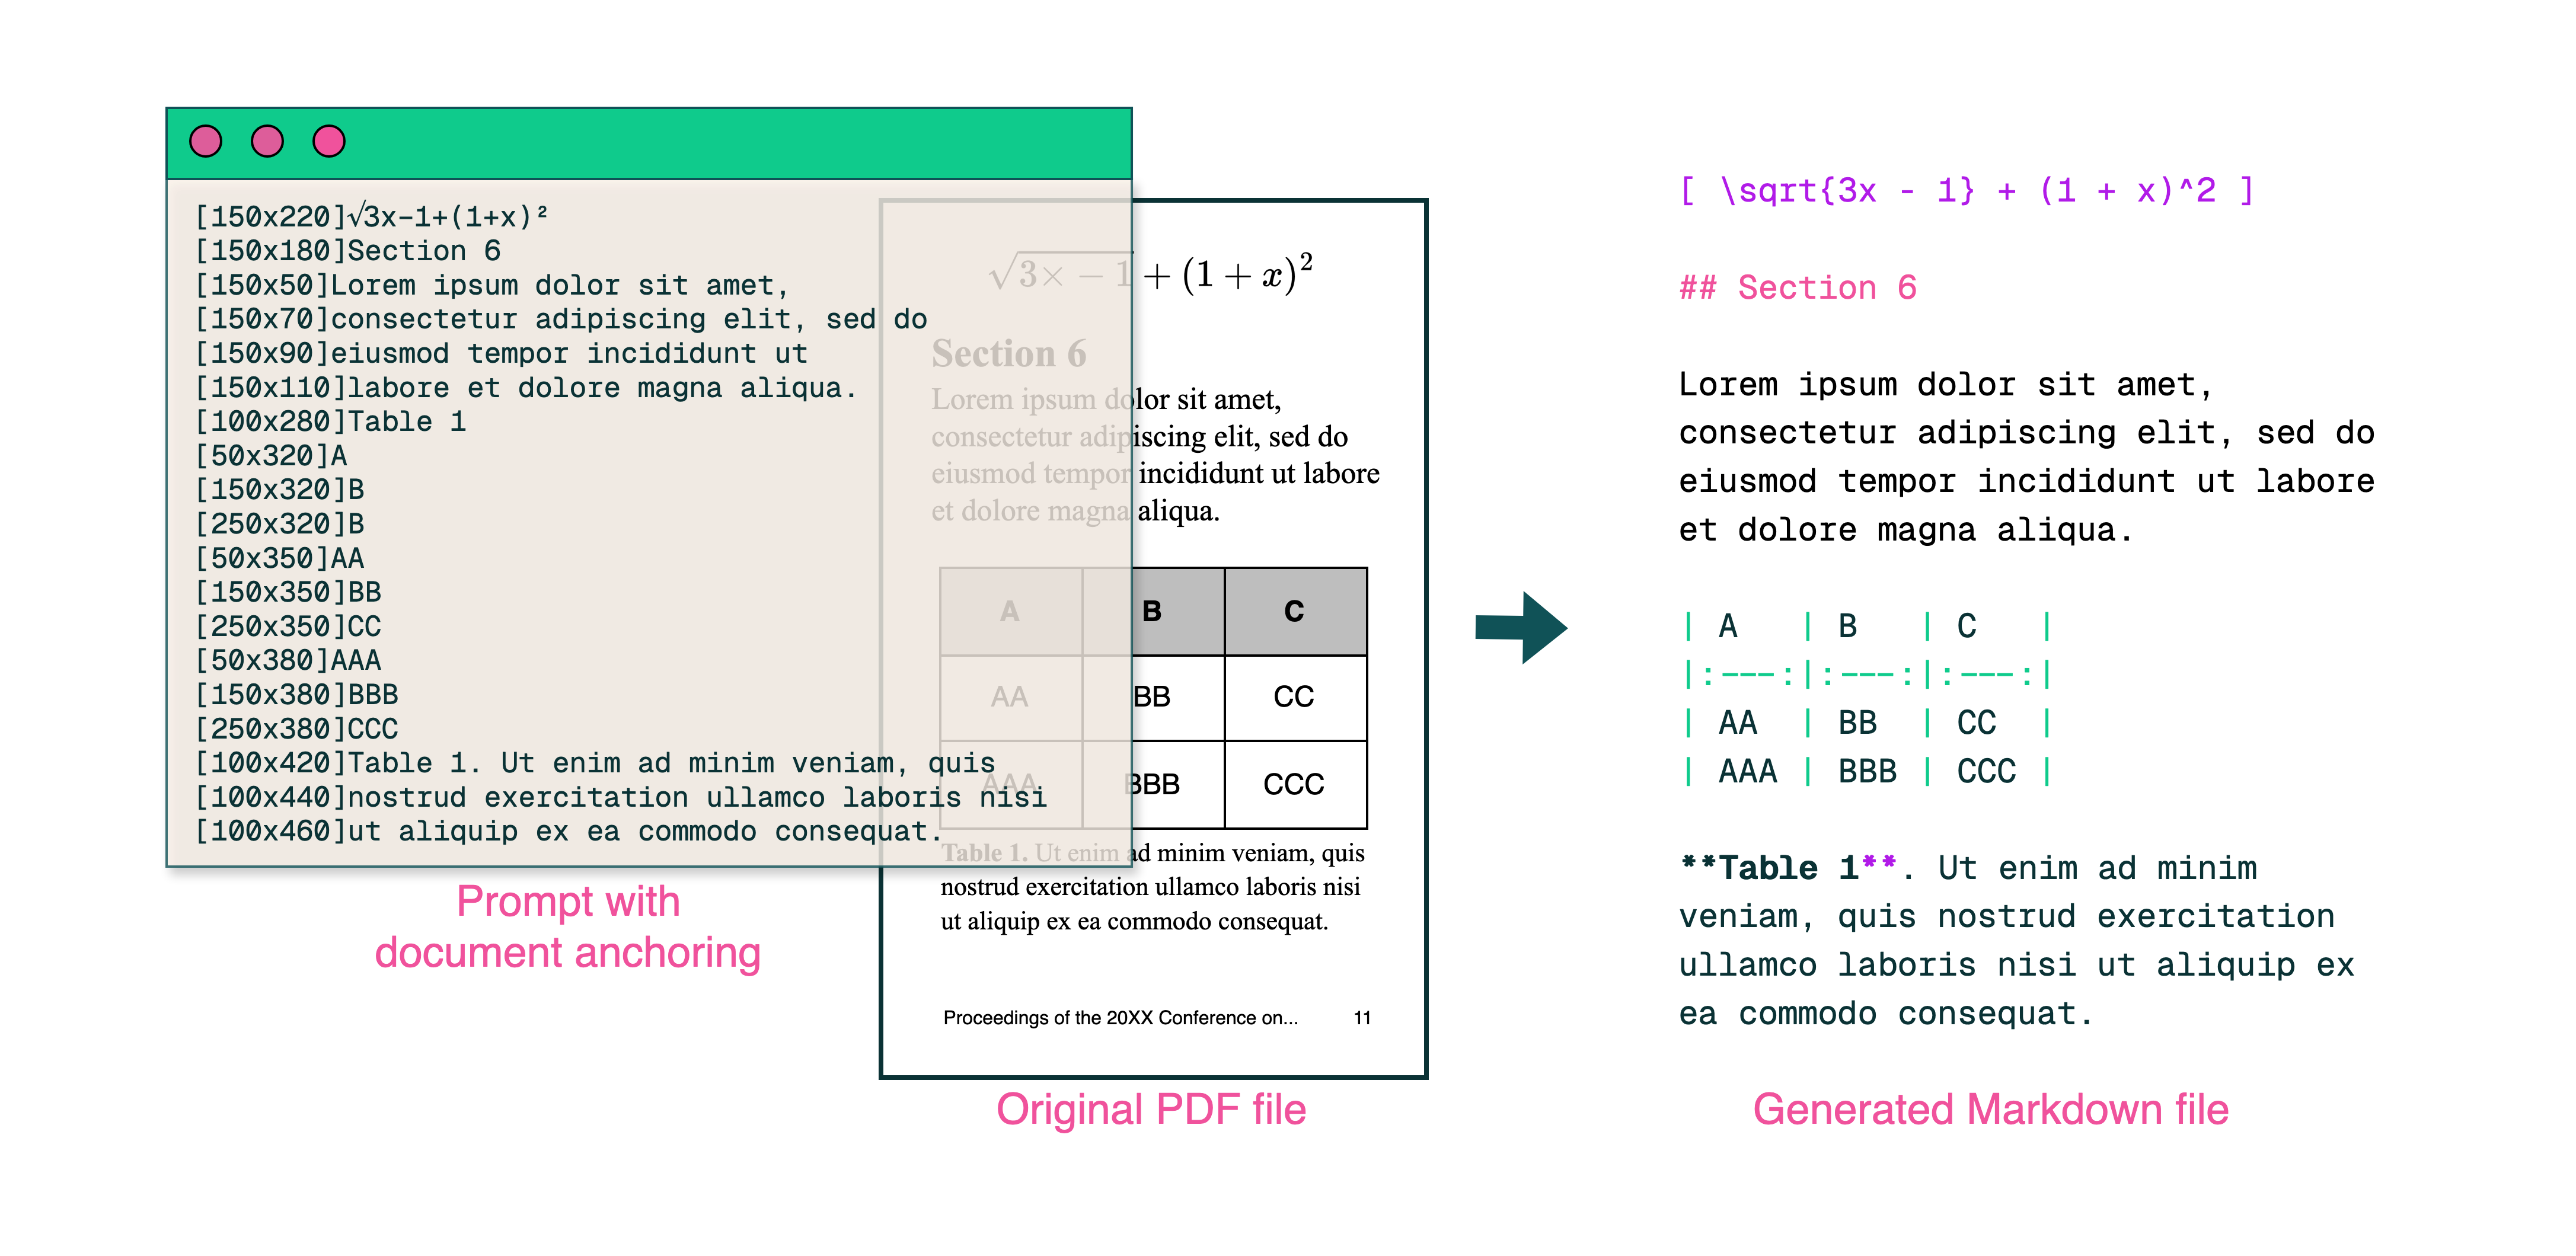
キャプション:olmOCRのエンドツーエンドパイプラインは、煩雑なPDFをGPT-4oの1/32のコストで、構造化されたMarkdownテキストに変換します。
PDFの隠れた課題:プレーンテキストが重要な理由
言語モデルはクリーンなテキストで動作しますが、PDFは究極の宿敵です。印刷用に設計されており、解析用ではないため、テキストの位置が混在し、表がバイナリコードに埋もれ、数式が視覚的なパズルに変わります。従来のOCRツールは、書式設定を見逃したり、複数列のレイアウトに苦労したり、法外な料金を請求したりすることがよくあります。
ここでolmOCRの登場です。これは、ビジョン言語モデル(VLM)とスマートエンジニアリングを組み合わせ、PDFコードを解読するオープンソースツールキットです。開発者や研究者がなぜこれに注目しているのか、その理由を詳しく見ていきましょう。
olmOCRが他のツールより優れている5つの理由
-
無視できないコスト効率
 100万ページを190ドルで処理できます。これは、GPT-4oバッチAPIよりも32倍安価です。その理由は、25万ページの多様なページ(学術論文、法的文書、手書きの手紙など)でファインチューニングを行い、SGLang/vLLMで推論を最適化しているからです。
-
Markdownマジック もう正規表現の悪夢はありません。olmOCRは、以下を備えたクリーンなMarkdownを出力します。
- 数式の保持(
E=mc²) - 表はそのまま
- 複雑なレイアウトの正しい読み取り順序
- 数式の保持(
-
すぐに使えるパイプライン
python -m olmocr.pipeline ./workspace --pdfs your_file.pdf1つから100以上のGPUまでシームレスに拡張できます。組み込みのエラー処理により、メタデータの破損など、一般的なPDFの問題に対処します。
-
オープンソース、ブラックボックスなし 重み、トレーニングデータ(はい、25万ページすべて!)、コードは公開されています。Qwen2-VL-7B-Instructに基づいて構築されており、独自の依存関係はありません。
-
人間が証明した優位性
Marker、GOT-OCR 2.0、MinerUとのブラインドテストでは、- 比較の**61%**で勝利
- ELO >1800(ゴールドスタンダード)を達成
内部構造:olmOCRの構築方法
ドキュメントアンカー:秘密のソース
 キャプション:テキスト+画像コンテキスト=正確な抽出。
トレーニング中に、PDF独自のテキスト/メタデータを使用してVLMを「アンカー」します。
- テキストブロックと画像領域を抽出
- モデルプロンプトでそれらを組み合わせる
- GPT-4oに「ゴールドスタンダード」ラベルを生成させる
結果?テキストが何を言っているのか、そしてそれがどこに属しているのかを理解するモデル。
現実世界のためのトレーニング
- データセット: 学術論文60%、パンフレット12%、法的文書11%
- ハードウェア: NVIDIA GPU向けに最適化されており、同等のセットアップよりもエネルギー使用量が90%削減
- ファインチューニング: ドキュメント「会話」用にQwen2-VL-7B-Instructを適応
3分でolmOCRを試す
- インストール
git clone https://github.com/allenai/olmocr && cd olmocr pip install -e . - サンプルPDFで実行
python -m olmocr.pipeline ./demo_output --pdfs tests/gnarly_pdfs/horribleocr.pdf - Markdownを確認
./demo_output/horribleocr.mdを開きます。表、数式、テキストの流れがそのまま表示されます!
最終的な結論
olmOCRは単なるツールではありません。パラダイムシフトです。VLMと透明性の高いエンジニアリングを組み合わせることで、高品質なテキスト抽出を誰でも利用できるようにします。研究コーパスの構築でも、請求書の自動化でも、このツールキットはあなたのスタックに不可欠です。
次のステップ
- ⭐ GitHubリポジトリにスターを付ける
- 📊 インタラクティブツールを使用して出力を比較する
- 💬 Hugging Faceでディスカッションに参加する
PDFの苦痛をプレーンテキストの利益に変えましょう! 🚀