
Effektiv PDF-tekstutvinning med Vision Language Models —— Hvorfor olmOCR endrer spillet
Oppdag hvordan olmOCR forvandler PDF-behandling med AI-drevet tekstutvinning, kostnadseffektivitet og åpen kildekode-innovasjon.
 Free OLM OCR Team
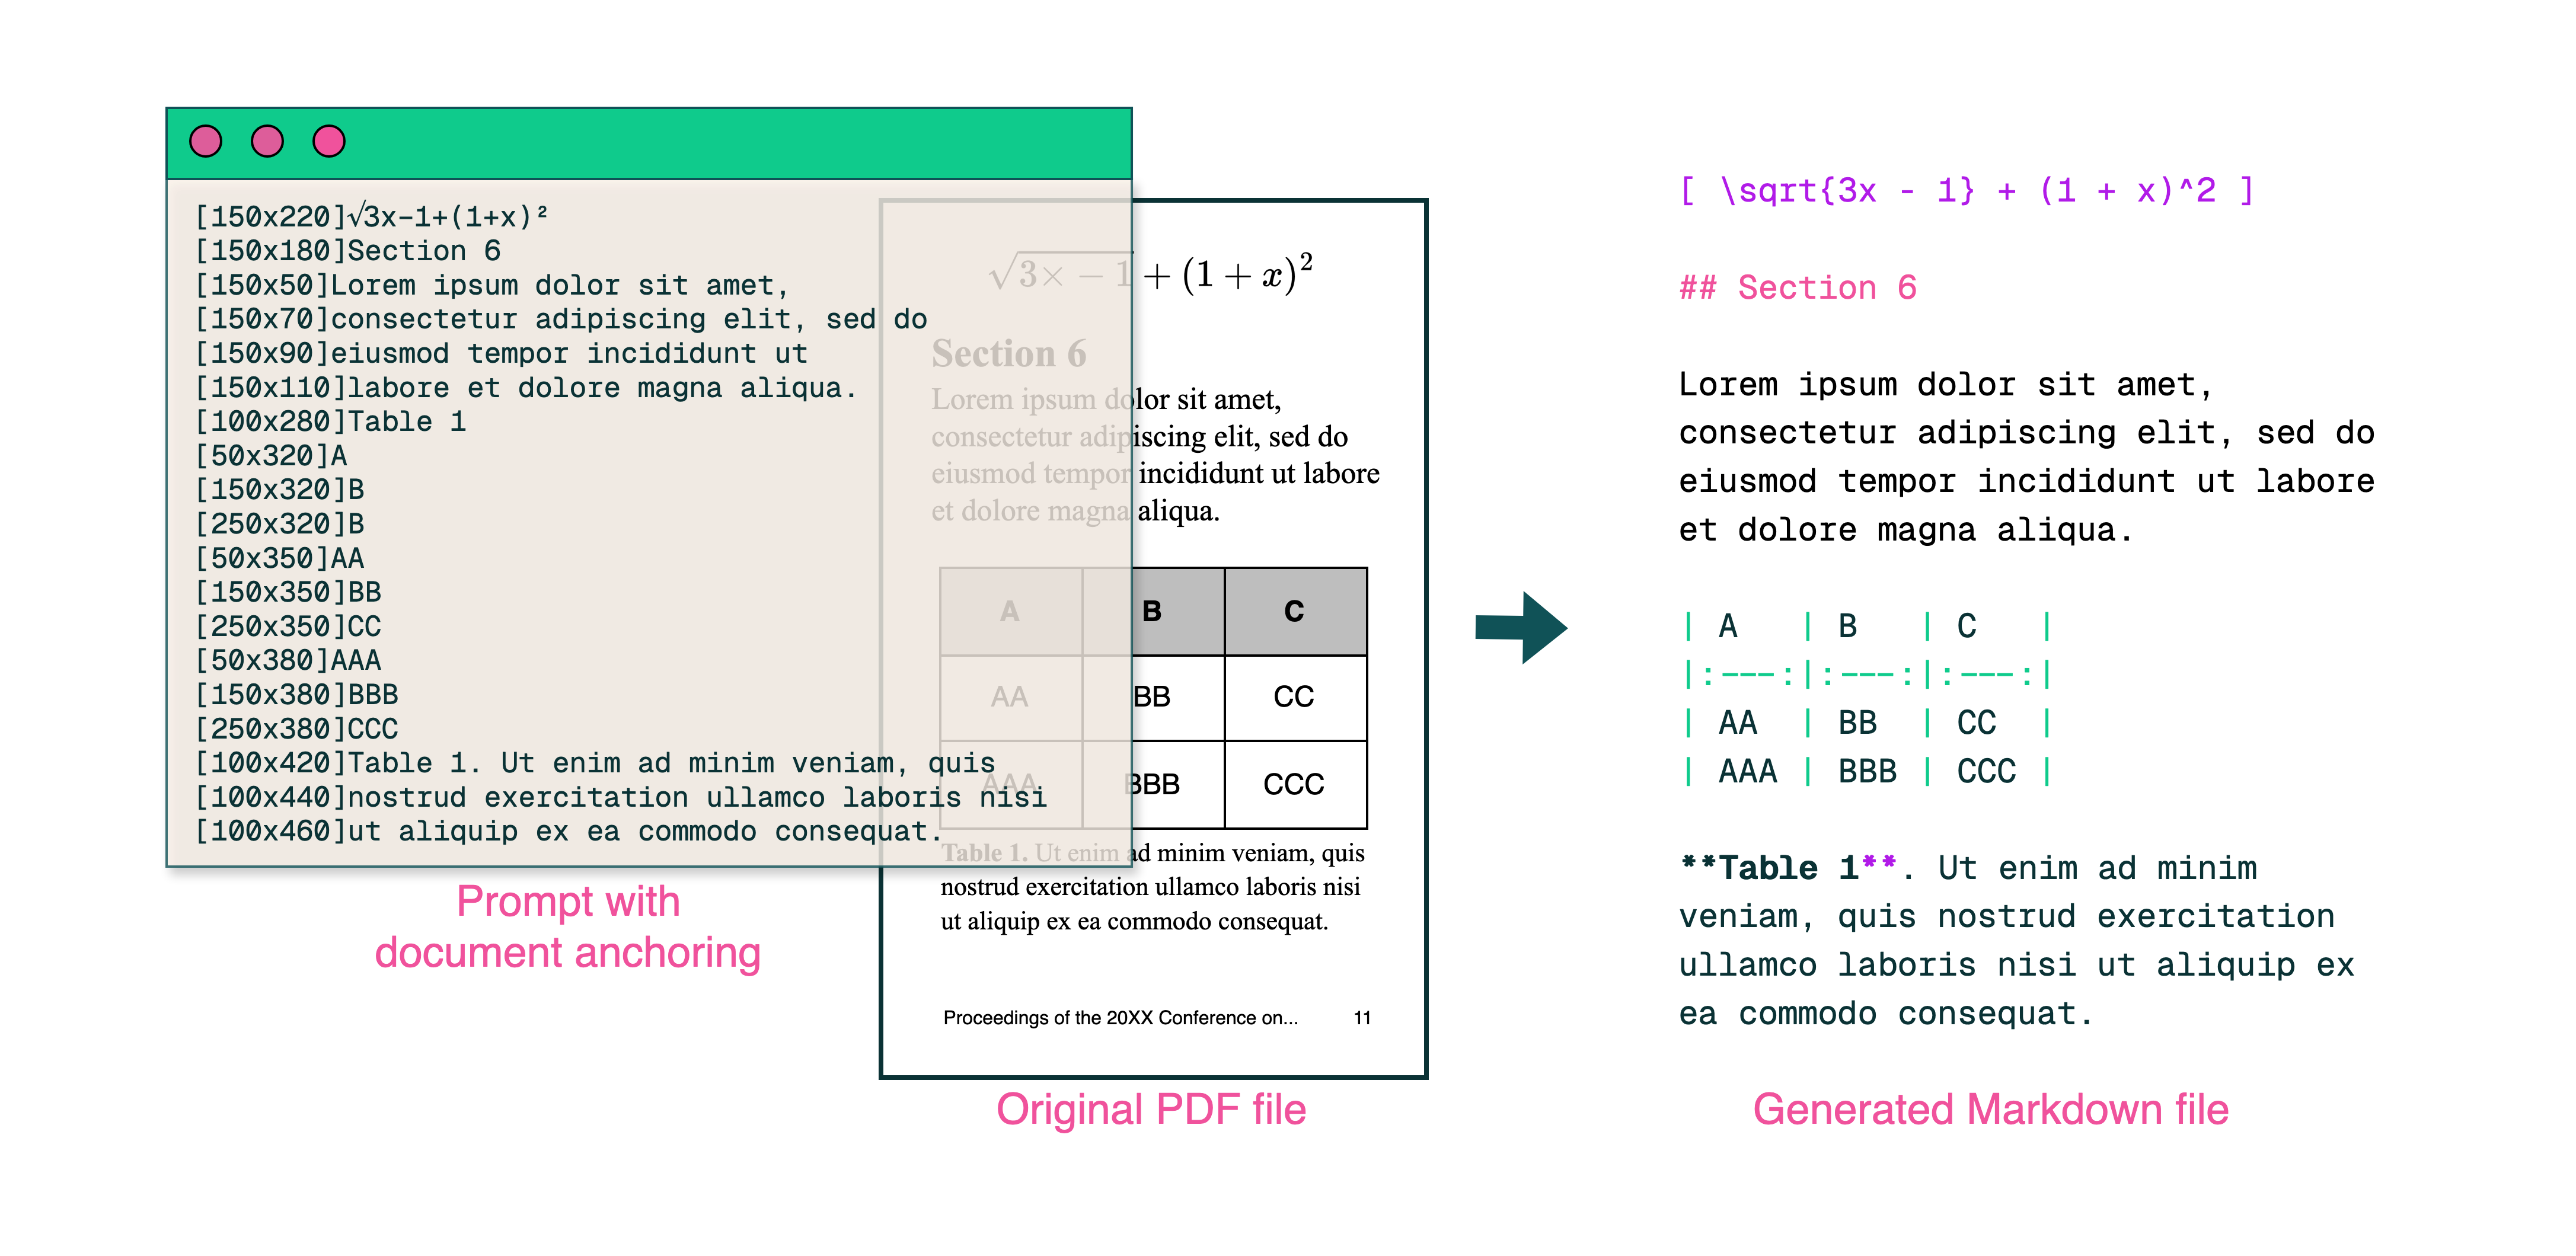
Bildetekst: olmOCRs end-to-end pipeline konverterer rotete PDF-er til strukturert Markdown-tekst til 1/32 av kostnaden for GPT-4o.
Den skjulte utfordringen med PDF-er: Hvorfor ren tekst er viktig
Språkmodeller trives på ren tekst – men PDF-er er den ultimate fienden. De er designet for utskrift, ikke parsing, og roter tekstposisjoner, begraver tabeller i binærkode og forvandler ligninger til visuelle gåter. Tradisjonelle OCR-verktøy? De går ofte glipp av formatering, sliter med layout med flere kolonner eller koster en formue.
Møt olmOCR: et verktøy med åpen kildekode som kombinerer vision-language models (VLM-er) med smart ingeniørarbeid for å knekke PDF-koden. La oss bryte ned hvorfor utviklere og forskere er begeistret for det.
5 grunner til at olmOCR overgår andre verktøy
-
Kostnadseffektivitet som er vanskelig å ignorere
 Behandle 1 million sider for $190 – det er 32x billigere enn GPT-4o batch-API-er. Hvordan? Ved finjustering på 250 000 forskjellige sider (akademiske artikler, juridiske dokumenter, til og med håndskrevne brev) og optimalisering av inferens med SGLang/vLLM.
-
Markdown-magi Ikke flere regex-mareritt. olmOCR gir ren Markdown med:
- Bevarte ligninger (
E=mc²) - Tabeller som forblir tabeller
- Riktig leserekkefølge for komplekse layouter
- Bevarte ligninger (
-
Batterier-inkludert pipeline
python -m olmocr.pipeline ./workspace --pdfs your_file.pdfSkaler sømløst fra 1 til 100+ GPU-er. Innebygd feilhåndtering takler vanlige PDF-problemer som metadata-korrupsjon.
-
Åpen kildekode, null svarte bokser Vekter, treningsdata (ja, alle 250 000 sidene!) og kode er offentlige. Bygget på Qwen2-VL-7B-Instruct – ingen proprietære avhengigheter.
-
Menneske-beviste overlegenhet
I blindtester mot Marker, GOT-OCR 2.0 og MinerU:- Vinner 61 % av sammenligningene
- Oppnår ELO >1800 (gullstandard)
Under panseret: Hvordan vi bygde olmOCR
Dokumentforankring: Hemmeligheten
 Bildetekst: Tekst + bildekontekst = nøyaktig utvinning.
Vi bruker PDF-ers egen tekst/metadata for å "forankre" VLM-er under trening:
- Utvinn tekstblokker og bilderegioner
- Kombiner dem i modellmeldinger
- La GPT-4o generere "gullstandard"-etiketter
Resultat? En modell som forstår både hva teksten sier og hvor den hører hjemme.
Trening for den virkelige verden
- Datasett: 60 % akademiske artikler, 12 % brosjyrer, 11 % juridiske dokumenter
- Maskinvare: Optimalisert for NVIDIA GPU-er, 90 % lavere energiforbruk enn sammenlignbare oppsett
- Finjustering: Qwen2-VL-7B-Instruct tilpasset for dokument "samtaler"
Prøv olmOCR på 3 minutter
- Installer
git clone https://github.com/allenai/olmocr && cd olmocr pip install -e . - Kjør på eksempel-PDF
python -m olmocr.pipeline ./demo_output --pdfs tests/gnarly_pdfs/horribleocr.pdf - Sjekk Markdown
Åpne
./demo_output/horribleocr.md– se tabeller, ligninger og tekstflyt intakt!
Siste ord
olmOCR er ikke bare et annet verktøy – det er et paradigmeskifte. Ved å kombinere VLM-er med transparent ingeniørarbeid, gjør det høykvalitets tekstutvinning tilgjengelig for alle. Enten du bygger et forskningskorpus eller automatiserer fakturabehandling, hører dette verktøysettet hjemme i din verktøykasse.
Neste steg
- ⭐ Stjernemerk GitHub-repoet
- 📊 Sammenlign utdata ved hjelp av Interaktivt verktøy
- 💬 Bli med i diskusjonen på Hugging Face
La oss forvandle PDF-plager til ren tekst-gevinst! 🚀