
การดึงข้อความ PDF อย่างมีประสิทธิภาพด้วย Vision Language Models —— ทำไม olmOCR ถึงเปลี่ยนเกม
ค้นพบว่า olmOCR เปลี่ยนแปลงการประมวลผล PDF ได้อย่างไร ด้วยการดึงข้อความที่ขับเคลื่อนด้วย AI, ประสิทธิภาพด้านต้นทุน และนวัตกรรมโอเพนซอร์ส
 Free OLM OCR Team
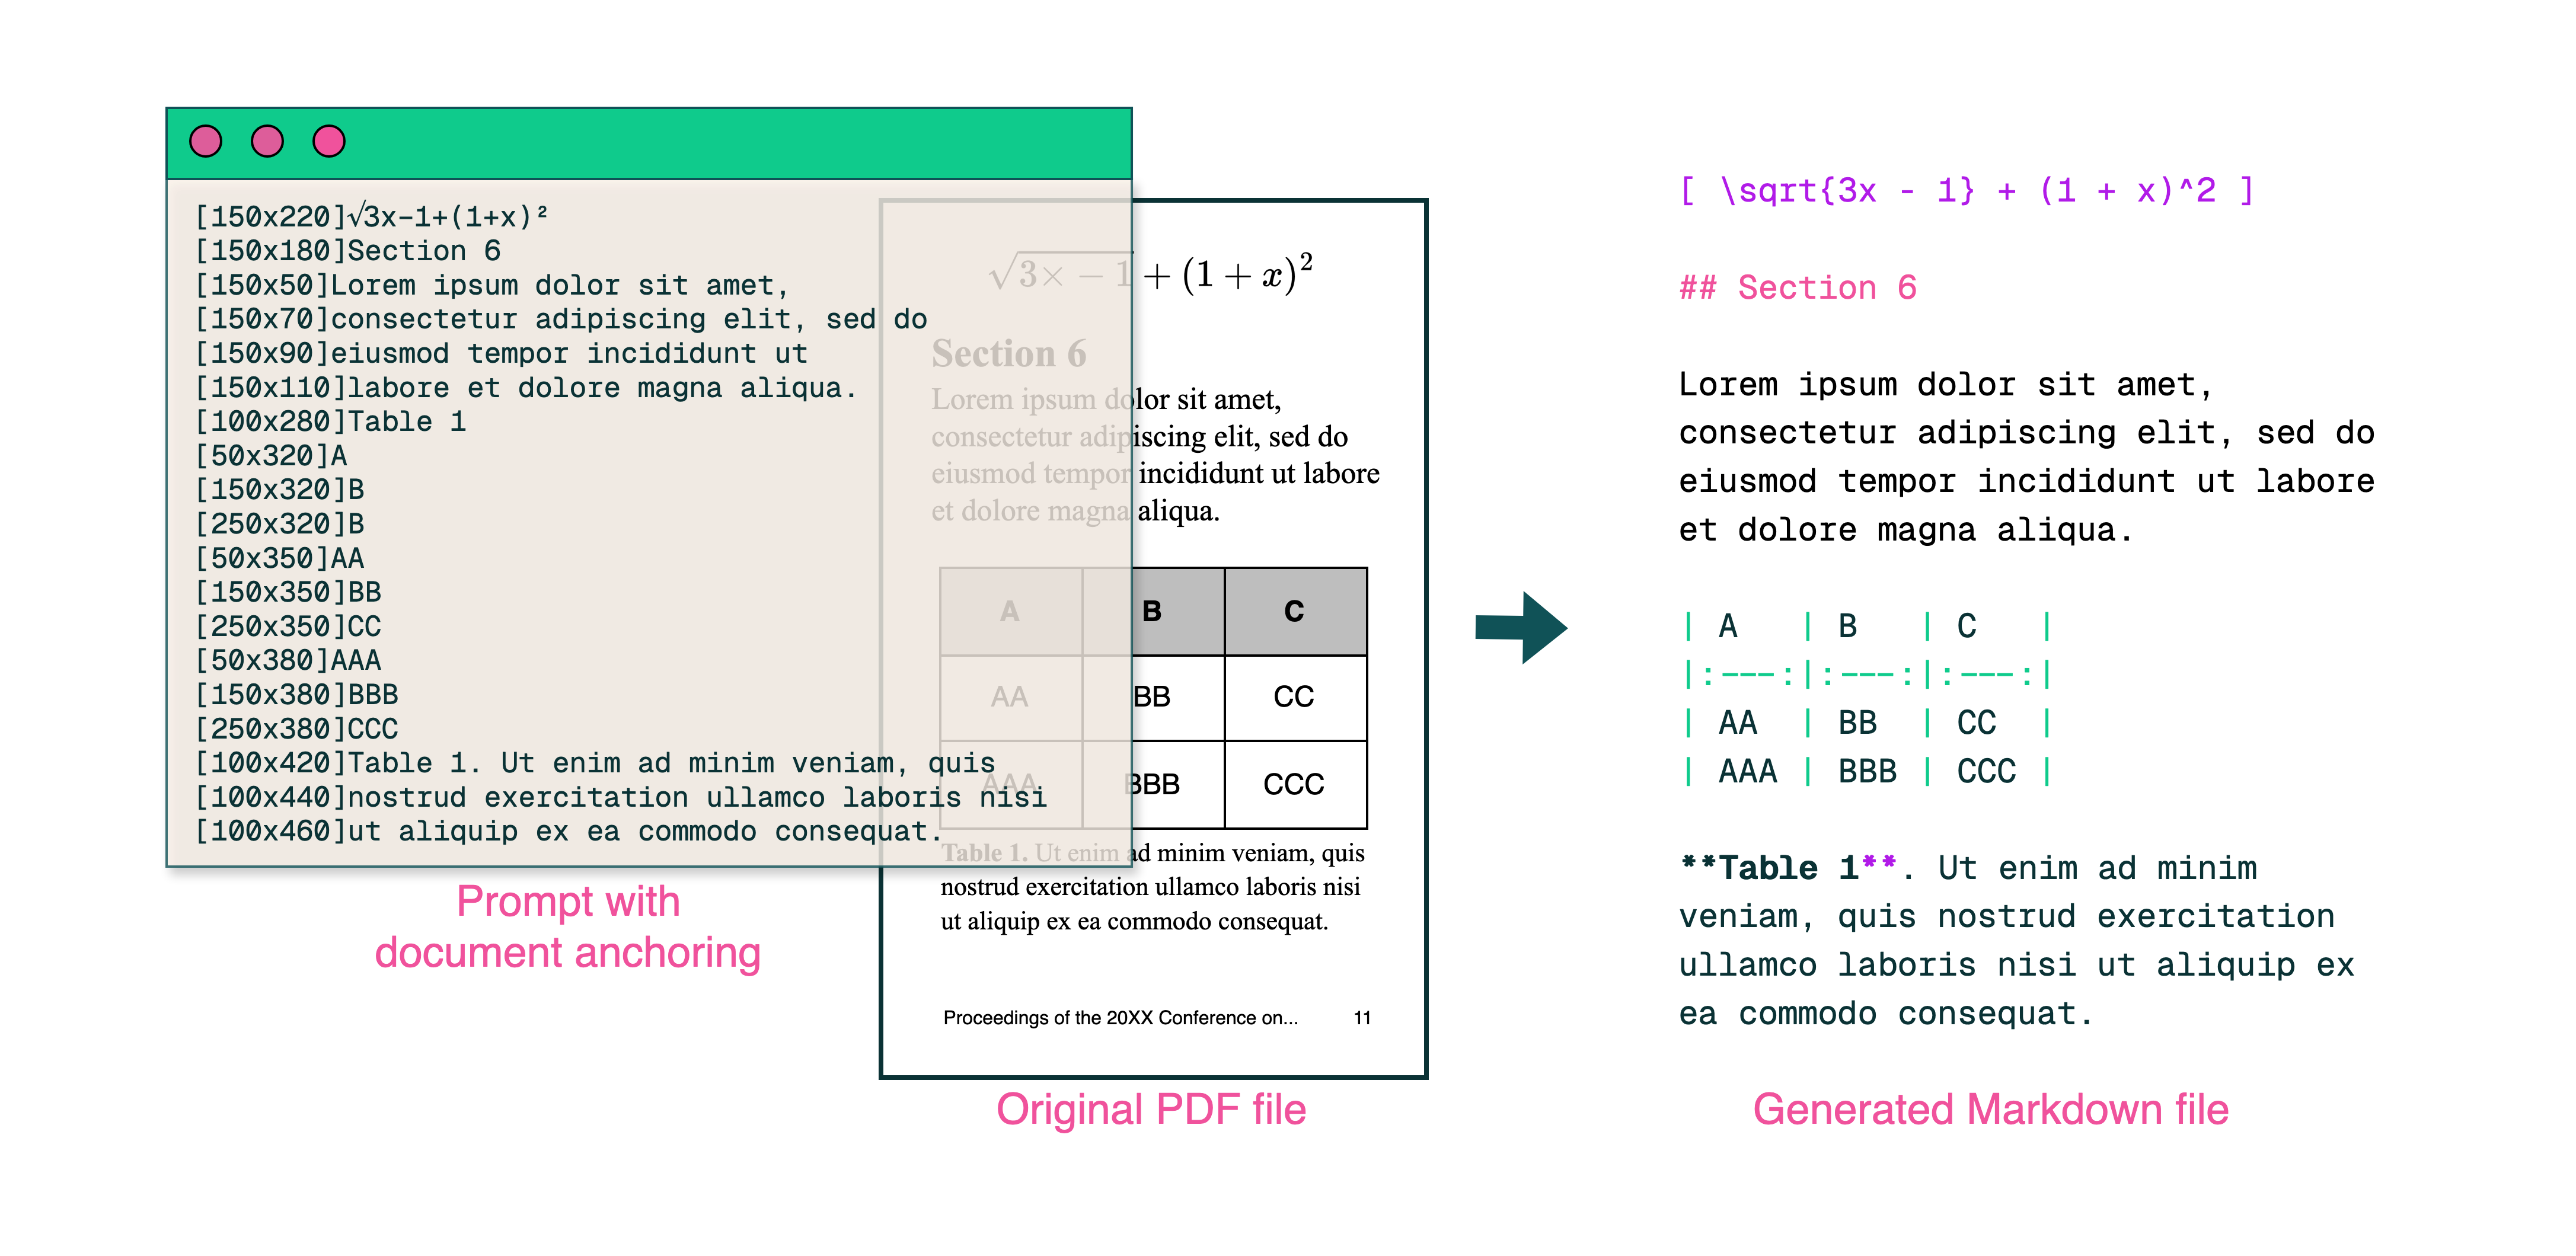
คำบรรยายภาพ: ไปป์ไลน์แบบครบวงจรของ olmOCR แปลง PDF ที่ยุ่งเหยิงให้เป็นข้อความ Markdown ที่มีโครงสร้างในราคาเพียง 1/32 ของ GPT-4o
ความท้าทายที่ซ่อนอยู่ของ PDF: ทำไมข้อความธรรมดาจึงมีความสำคัญ
โมเดลภาษาเจริญเติบโตได้ดีบนข้อความที่สะอาด—แต่ PDF คือศัตรูที่แท้จริง ออกแบบมาเพื่อการพิมพ์ ไม่ใช่การแยกวิเคราะห์ พวกมันทำให้ตำแหน่งข้อความสับสน ฝังตารางไว้ในรหัสไบนารี และเปลี่ยนสมการให้เป็นปริศนาภาพ เครื่องมือ OCR แบบดั้งเดิม? พวกมันมักจะพลาดการจัดรูปแบบ มีปัญหาในการจัดวางหลายคอลัมน์ หรือคิดค่าใช้จ่ายมหาศาล
ขอแนะนำ olmOCR: ชุดเครื่องมือโอเพนซอร์สที่รวมโมเดลภาษาภาพ (VLMs) เข้ากับการออกแบบทางวิศวกรรมอัจฉริยะเพื่อถอดรหัส PDF มาดูกันว่าทำไมนักพัฒนาและนักวิจัยถึงตื่นเต้นกับมัน
5 เหตุผลที่ olmOCR เหนือกว่าเครื่องมืออื่นๆ
-
ประสิทธิภาพด้านต้นทุนที่ยากจะมองข้าม
 ประมวลผล 1 ล้านหน้าในราคา $190—นั่นถูกกว่า API แบบกลุ่มของ GPT-4o ถึง 32 เท่า ทำได้อย่างไร? โดยการปรับแต่งบนหน้ากระดาษที่หลากหลาย 250K หน้า (เอกสารวิชาการ เอกสารทางกฎหมาย แม้แต่จดหมายที่เขียนด้วยลายมือ) และปรับการอนุมานให้เหมาะสมด้วย SGLang/vLLM
-
Markdown Magic ไม่ต้องเจอกับฝันร้าย regex อีกต่อไป olmOCR ให้ผลลัพธ์เป็น Markdown ที่สะอาดพร้อม:
- รักษาสมการ (
E=mc²) - ตารางที่ยังคงเป็นตาราง
- ลำดับการอ่านที่ถูกต้องสำหรับการจัดวางที่ซับซ้อน
- รักษาสมการ (
-
ไปป์ไลน์ที่รวมทุกอย่างไว้แล้ว
python -m olmocr.pipeline ./workspace --pdfs your_file.pdfปรับขนาดจาก 1 เป็น 100+ GPUs ได้อย่างราบรื่น การจัดการข้อผิดพลาดในตัวจัดการปัญหา PDF ทั่วไป เช่น การเสียหายของข้อมูลเมตา
-
โอเพนซอร์ส ไม่มีกล่องดำ น้ำหนัก ข้อมูลการฝึกอบรม (ใช่ ทั้งหมด 250K หน้า!) และโค้ดเป็นสาธารณะ สร้างขึ้นบน Qwen2-VL-7B-Instruct—ไม่มีการพึ่งพาที่เป็นกรรมสิทธิ์
-
ความเหนือกว่าที่ได้รับการพิสูจน์แล้วจากมนุษย์
ในการทดสอบแบบตาบอดกับ Marker, GOT-OCR 2.0 และ MinerU:- ชนะ 61% ของการเปรียบเทียบ
- ได้ ELO >1800 (มาตรฐานทองคำ)
ภายใต้ฝากระโปรง: เราสร้าง olmOCR ได้อย่างไร
การยึดเอกสาร: ซอสลับ
 คำบรรยายภาพ: บริบทข้อความ + รูปภาพ = การดึงข้อมูลที่แม่นยำ
เราใช้ข้อความ/ข้อมูลเมตาของ PDF เองเพื่อ "ยึด" VLMs ในระหว่างการฝึกอบรม:
- ดึงบล็อกข้อความและส่วนรูปภาพ
- รวมเข้าด้วยกันในพรอมต์โมเดล
- ให้ GPT-4o สร้างป้ายกำกับ "มาตรฐานทองคำ"
ผลลัพธ์? โมเดลที่เข้าใจทั้ง สิ่งที่ ข้อความพูดและ ที่ที่ มันควรอยู่
การฝึกอบรมสำหรับโลกแห่งความเป็นจริง
- ชุดข้อมูล: เอกสารวิชาการ 60%, โบรชัวร์ 12%, เอกสารทางกฎหมาย 11%
- ฮาร์ดแวร์: ปรับให้เหมาะสมสำหรับ NVIDIA GPUs, ใช้พลังงานน้อยกว่าการตั้งค่าที่เทียบเคียงได้ 90%
- การปรับแต่ง: Qwen2-VL-7B-Instruct ปรับให้เข้ากับการ "สนทนา" ของเอกสาร
ลองใช้ olmOCR ใน 3 นาที
- ติดตั้ง
git clone https://github.com/allenai/olmocr && cd olmocr pip install -e . - รันบน PDF ตัวอย่าง
python -m olmocr.pipeline ./demo_output --pdfs tests/gnarly_pdfs/horribleocr.pdf - ตรวจสอบ Markdown
เปิด
./demo_output/horribleocr.md—ดูตาราง สมการ และการไหลของข้อความยังคงอยู่!
สรุปสุดท้าย
olmOCR ไม่ได้เป็นเพียงเครื่องมืออื่น—แต่มันคือการเปลี่ยนแปลงกระบวนทัศน์ ด้วยการรวม VLMs เข้ากับการออกแบบทางวิศวกรรมที่โปร่งใส ทำให้การดึงข้อความคุณภาพสูงเข้าถึงได้สำหรับทุกคน ไม่ว่าคุณจะสร้างคลังข้อมูลการวิจัยหรือทำให้การประมวลผลใบแจ้งหนี้เป็นไปโดยอัตโนมัติ ชุดเครื่องมือนี้ควรอยู่ในสแต็กของคุณ
ขั้นตอนต่อไป
- ⭐ กดดาวที่ GitHub repo
- 📊 เปรียบเทียบผลลัพธ์โดยใช้ เครื่องมือแบบโต้ตอบ
- 💬 เข้าร่วมการสนทนาบน Hugging Face
มาเปลี่ยนความเจ็บปวดจาก PDF ให้เป็นข้อความธรรมดาที่ได้รับ! 🚀